Collegamento delle apparecchiature al LIMS tramite l'editor dell'interfaccia di importazione

Interfacce di importazione: importazione automatica dei dati nel LIMS

Collegare al LIMS strumenti di analisi, macchine di collaudo, laboratori esterni e sistemi ERP come SAP: CSV, JSON, XML, REST-API e SFTP — con mappatura basata sull’intelligenza artificiale.

La vita quotidiana senza interfaccia

Quattro aspetti che richiedono tempo in laboratorio — e causano errori

I valori vengono digitati

Il dispositivo stampa o esporta i dati, mentre qualcuno inserisce manualmente i numeri nel sistema. Ogni valore viene elaborato due volte e, proprio durante la seconda elaborazione, si verificano gli errori di inversione dei numeri.

Ogni dispositivo comunica in modo diverso

Un dispositivo genera un punto e virgola, il successivo un tabulatore, mentre il terzo inizia l’intestazione solo alla riga 13. Per ogni formato viene gestito un apposito file Excel creato ad hoc.

L'assegnazione viene effettuata manualmente

In assenza di una chiave univoca, qualcuno deve decidere a quale campione appartenga un valore di misura. Questo sistema funziona — finché un giorno non funziona più e la cosa viene rilevata durante l'audit.

Per ogni connessione è necessario l'intervento del reparto IT

Una nuova interfaccia comporta un ticket, un fornitore di servizi e tempi di attesa. Fino ad allora, la fase intermedia continuerà a essere gestita tramite Excel.

È proprio a questo scopo che esiste l’editor delle interfacce di importazione del LDB LIMS: uno strumento che consente di integrare i numerosi dispositivi, sistemi e laboratori esterni, molto diversi tra loro e con livelli di utilizzo variabili — dall’analizzatore che fornisce dati ogni ora al laboratorio partner che invia un file tre volte all’anno.

Funzioni principali

Non solo valori misurati — praticamente tutto ciò che arriva in laboratorio

L'editor dell'interfaccia di importazione non si limita ai dispositivi di analisi. Tramite la stessa interfaccia vengono importati anche gli ordini, i dati anagrafici e i documenti.

È possibile importare questi dati

  • Valori misurati
  • Campioni
  • Ordini
  • Clienti e contatti
  • Strumenti di controllo
  • Materiali e lotti
  • Allegati
  • Fatture e preventivi
  • Relazioni e specifiche
  • Ricette, modelli, attività

A ciò si aggiungono note, registrazione delle ore lavorative e file: in totale 19 tipi di dati che possono essere creati o aggiornati tramite interfacce di importazione.

Formati supportati

CSVJSONXMLHL7LDTPDFPNGJPG

HL7 e LDT coprono lo scambio di dati medici. Anche Excel è compatibile: è sufficiente salvare il file in formato CSV direttamente da Excel. Tutto il resto viene aggiunto tramite un codice di trasformazione.

Vie di trasmissione

Qual è la soluzione più adatta al Suo dispositivo?

Quattro modalità, dal funzionamento manuale a quello completamente automatico. La scelta dipende da tre fattori: le funzionalità del vostro sistema di origine, le possibilità offerte dal vostro sistema informatico e la frequenza con cui arrivano i dati.

Caricare un file

Manuale

Caricare il file di esportazione del dispositivo direttamente nell’interfaccia. La soluzione ideale per chi è alle prime armi e per i dispositivi che vengono utilizzati raramente.

Impegno informatico: nessuno
Ideale per: fase di prova, piccole quantità

SFTP / FTP

Standard per le apparecchiature

Il dispositivo salva il file sul server; LDB LIMS lo recupera automaticamente. I file importati vengono spostati o eliminati.

Frequenza di aggiornamento: ogni 10 minuti
Quota: 10 file per ciclo
Porta: 22 (SFTP) · 21 (FTP)

HTTPS / REST

Push e Pull

Il sistema esterno invia attivamente i dati tramite POST, oppure il database del laboratorio li recupera autonomamente. Il metodo più veloce — quasi in tempo reale.

Autenticazione: Autenticazione di base o certificato
Risposta: 200 (operazione riuscita) · 400 (rifiutata)
Adatto per: ERP, portali, laboratori esterni

Ricezione delle e-mail

Senza progetto informatico

L'interfaccia accetta allegati via e-mail. Utile per i laboratori partner che non offrono altre soluzioni.

Onere informatico: minimo
Indicato per: laboratori esterni, referti singoli

MCP

Intelligenza artificiale e assistenti vocali

ChatGPT, Claude e altre applicazioni di intelligenza artificiale trasmettono i dati tramite interfacce di importazione condivise: il referto patologico viene dettato anziché digitato, il prelievo dei campioni durante gli spostamenti viene registrato a voce e i risultati delle analisi microbiologiche vengono documentati senza bisogno di usare le mani.

Autorizzazione: Siete voi a stabilire quali interfacce l’IA può utilizzare
Diritti: associati a un utente LDB
Audit trail: ogni modifica contrassegnata con «MCP»
Maggiori informazioni su MCP

Modulo personalizzato

Registrare anziché esportare

Potete creare una pagina HTML personalizzata o un modulo — per il campionamento in loco, per i mittenti o per una registrazione che non esiste ancora in questa forma. Una volta inviati, i dati inseriti vengono trasferiti direttamente nell’interfaccia di importazione.

Percorso: Modulo → Ricezione HTTPS
Indicato per: Prelievatori di campioni, mittenti, casi particolari
Senza file: I dati inseriti vengono immediatamente salvati come record
Immagini e file PDF vengono associati al campione corretto tramite il nome del file, un codice QR o l'intelligenza artificiale.
Registro di controllo registra integralmente ogni importazione, compresi i dati grezzi.
Mappatura delle importazioni

Colonna su campo — una volta configurata, funziona da sola

Durante la mappatura, si specifica quale colonna del proprio file debba essere associata a quale campo del LDB LIMS: cliente, ordine, campione, punto di campionamento, parametro, valore misurato.

Lei carica un file di esempio, LDB LIMS legge la riga degli attributi e Lei procede all’assegnazione. Non ha importanza se i parametri sono disposti uno accanto all’altro in colonne o uno sotto l’altro in righe: la mappatura segue la struttura del Suo file, non viceversa.
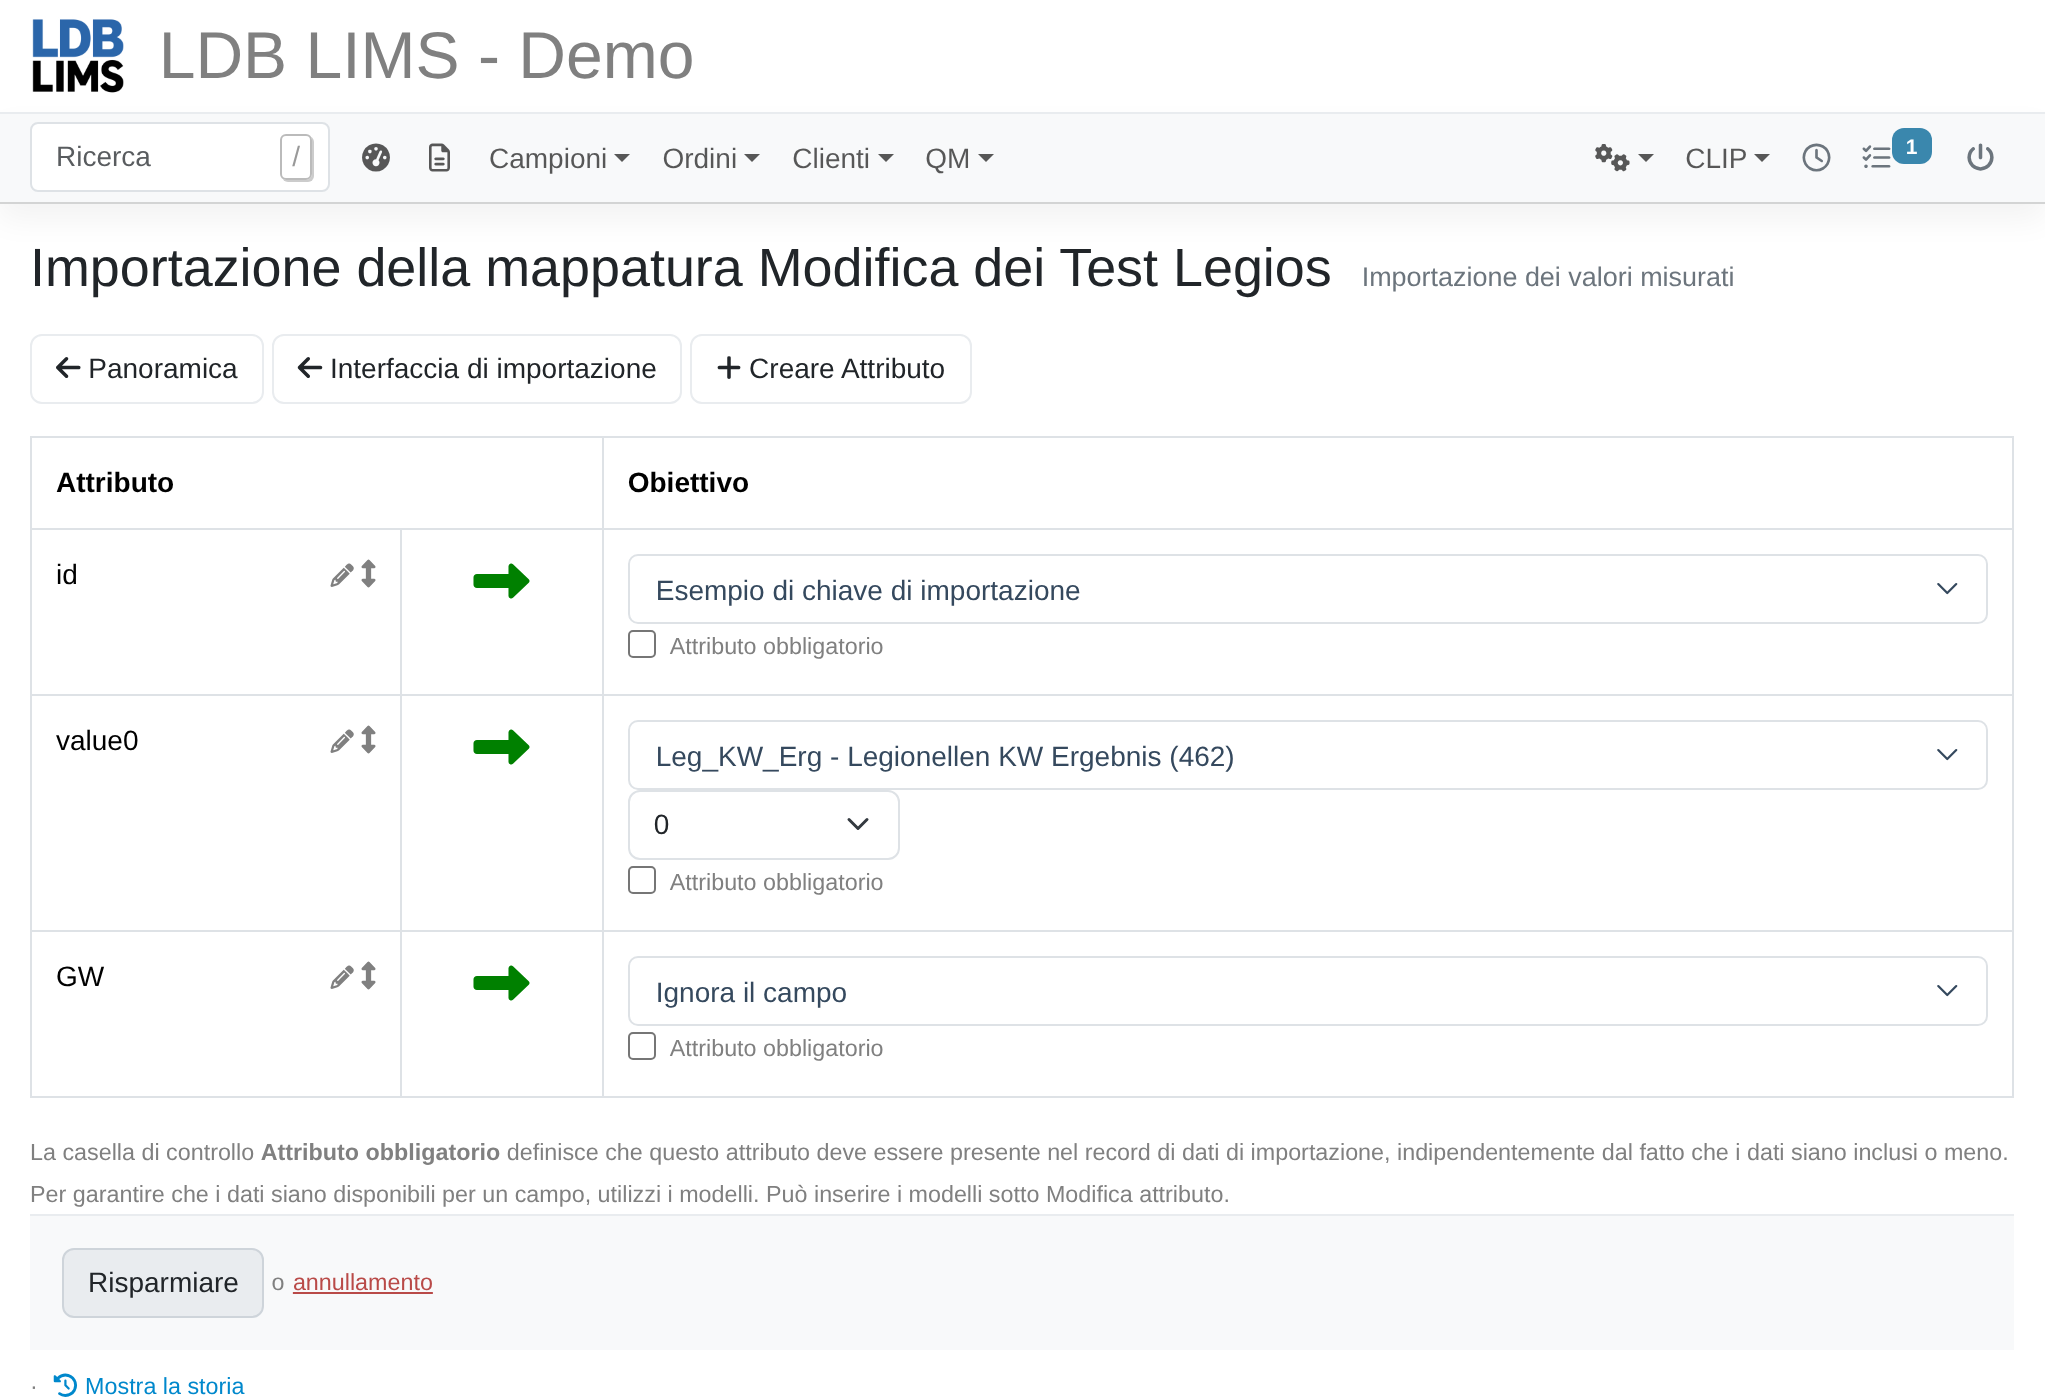
Schermata: mappatura delle importazioni con assegnazione degli attributi

Modificare la denominazione

A ogni attributo viene assegnato un nome descrittivo: un’intestazione di colonna criptica diventa così “Campionatore”.

Impostare un valore predefinito

Se un campo nel file di importazione è vuoto, il database del laboratorio lo compila automaticamente con il valore predefinito memorizzato.

Unire i campi

È possibile unire più colonne in un unico campo: il nome e il cognome vengono uniti in un unico nome.

Verificare i dati inseriti

Un modello convalida i dati già durante l'importazione: se un valore non corrisponde al formato previsto, l'importazione viene interrotta, anziché creare dati errati.

E se il file non fosse affatto un CSV?

Successivamente, un codice di trasformazione genera il formato richiesto prima che la mappatura abbia effetto. Gli amministratori del Suo laboratorio possono scrivere e gestire autonomamente tale codice. In alternativa, possiamo occuparcene noi come servizio a tariffa oraria. Nella finestra di importazione vedrà quindi entrambi i dati affiancati: i dati grezzi e la versione convertita.

Codice di trasformazione nel manuale
Ampliamento dell'intelligenza artificiale

Convertire i dati non strutturati in dati strutturati

Protocolli di campionamento redatti a mano, risultati di misurazione fotografati, file PDF provenienti dai committenti o da laboratori esterni: l’estensione basata sull’intelligenza artificiale converte i documenti non strutturati in dati strutturati, li verifica e li trasferisce alla funzione di importazione.
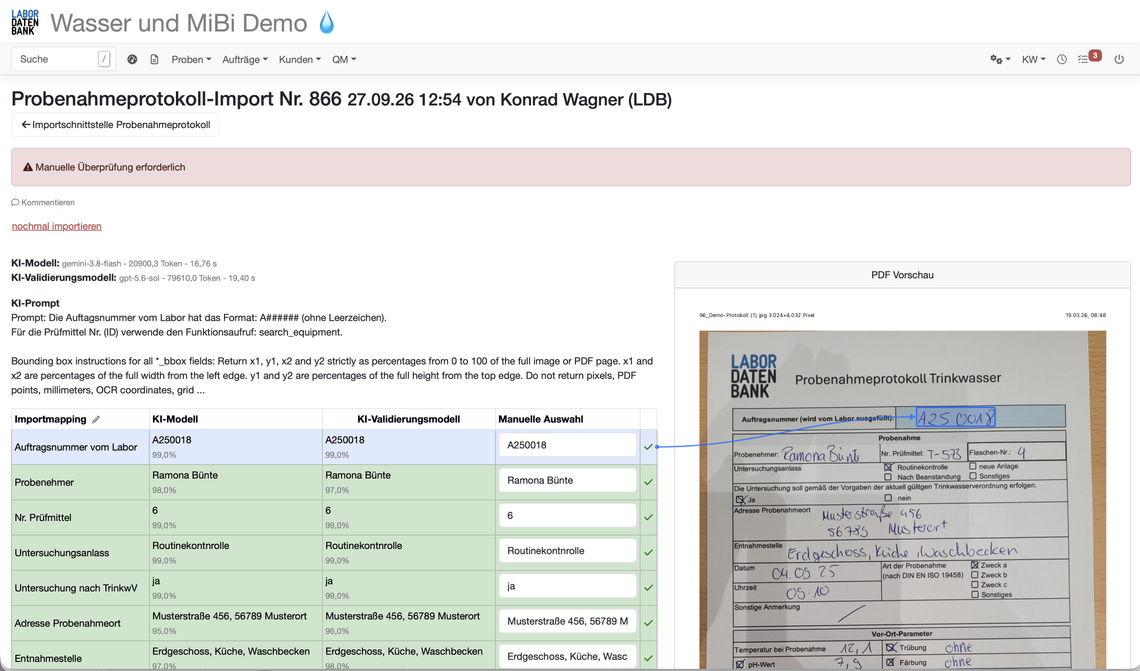
Screenshot: importazione, supportata dall’intelligenza artificiale, di un verbale di campionamento scritto a mano con convalida

Due modelli anziché uno

Un modello effettua una lettura, mentre un secondo modello ne verifica il risultato in modo indipendente. Entrambe le proposte sono presentate una accanto all’altra, ciascuna con il proprio valore di confidenza: si può vedere immediatamente in quali punti concordano e in quali no.

Ogni valore rimane dimostrabile

Per ogni campo riconosciuto, la banca dati di laboratorio indica la posizione nel documento originale da cui proviene il valore. I dati non univoci vengono contrassegnati per la verifica manuale, anziché essere acquisiti automaticamente.

Accesso ai Suoi dati anagrafici

L'intelligenza artificiale può effettuare ricerche mirate nel database — ad esempio, individuare lo strumento di prova menzionato e associarlo correttamente. Non fornisce consigli, ma effettua ricerche.

Le informazioni dettagliate sul funzionamento dell'estensione AI, sui tipi di dati che riconosce e su come configurarla per ciascuna interfaccia sono disponibili nella pagina dedicata.

Visualizzare le importazioni basate sull'intelligenza artificiale
Modalità di importazione

Siete voi a decidere cosa può essere sovrascritto

Un’importazione può creare, aggiornare o, se lo si desidera, non modificare nulla. La modalità viene impostata per ciascuna interfaccia e si applica quindi a ogni esecuzione.

L'impostazione predefinita è update: il nuovo valore viene applicato in ogni caso. Esistono inoltre modalità che compilano solo i parametri vuoti, aggiornano solo quelli già presenti, creano i parametri mancanti senza valore oppure aggiungono i valori misurati a una serie numerica esistente. Chi non desidera sovrascrivere alcun dato in caso di misurazione ripetuta, può selezionare una modalità «ignora» — con o senza avviso.

Tutte le modalità di importazione descritte nel manuale
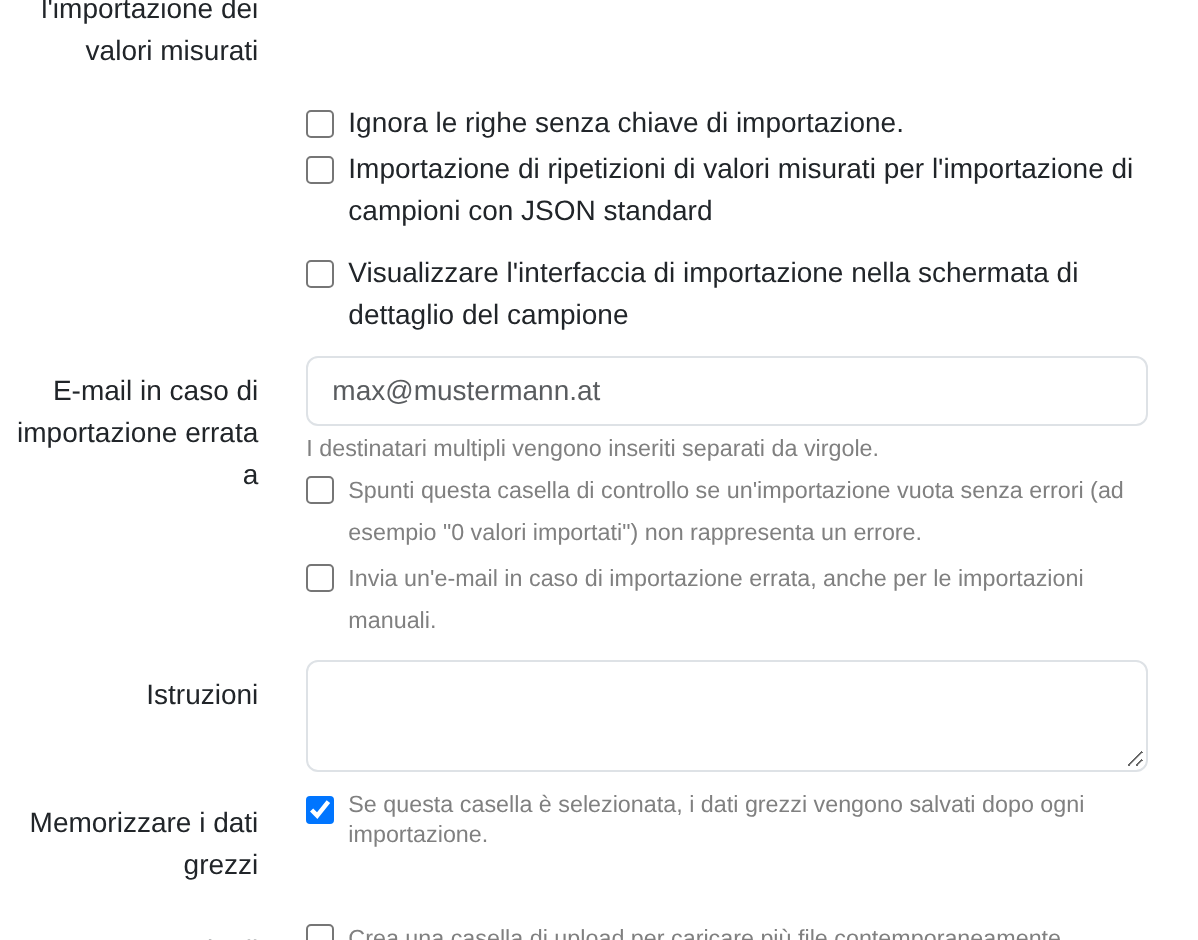
Schermata: selezione della modalità di importazione dei valori di misura

Testare e individuare gli errori

Solo nel sistema di prova

Ogni interfaccia viene innanzitutto configurata in tale ambiente e verificata utilizzando file di esempio anonimizzati. Entra in produzione solo dopo aver superato con successo la validazione.

Verificare la connessione

Con un solo clic è possibile verificare SFTP o FTP: raggiungibilità, credenziali di accesso e diritti di scrittura. L'interfaccia HTTPS risponde con un codice 200 o 400 prima che avvenga l'effettivo trasferimento dei dati.

Verificare anche i casi particolari

Campi obbligatori mancanti, ID sconosciuti, caratteri speciali, valori vuoti: ciò che può andare storto nella pratica quotidiana deve essere verificato durante i test — non durante il primo ciclo operativo.

Andamento e ripetizione

Ogni processo di importazione viene registrato e può essere ripetuto. In caso di errori, è possibile individuare con precisione dove si verifica il problema: file di origine, chiave, mappatura o trasformazione.

Apparecchiature e sistemi

Abbiamo già collegato questi dispositivi e sistemi

E tutto ciò che qui non è indicato viene aggiunto tramite mappatura e trasformazione: il formato del dispositivo determina solo la quantità di lavoro preliminare necessaria.

Strumenti di analisi

  • Agilent
  • Bruker
  • Leco
  • Tecan
  • Zwick
  • GC/MS
  • HPLC · IC · MS
  • Waagen · Titratoren

Software del dispositivo

ERP e gestione delle scorte

  • SAP
  • SAP Business One
  • Microsoft Dynamics
  • Navision
  • ProAlpha
  • AS/400
  • Salesforce
  • DATEV

Studio medico e laboratori esterni

  • Tomedo
  • M1
  • eTermin
  • Caritasnet
  • neolution
  • Novid20
  • HL7 · LDT
Il Suo dispositivo non è presente nell’elenco? Ci invii un file di esportazione di esempio. Durante il workshop sulle interfacce, di norma chiariremo nel corso di un unico incontro se è sufficiente il mapping o se è necessario un codice di trasformazione.
Verifica del file di esportazione

Domande frequenti sulle interfacce di importazione e sul collegamento dei dispositivi

Tramite le interfacce di importazione è possibile collegare alla banca dati di laboratorio strumenti di analisi, macchine di prova, registratori di temperatura e dati, laboratori esterni e sistemi ERP. Come modalità di trasmissione sono disponibili il caricamento manuale, SFTP, l’API HTTPS/REST, la ricezione tramite e-mail, un modulo personalizzato o MCP per gli assistenti basati sull’intelligenza artificiale. La scelta della modalità più adatta dipende dal sistema di origine, dai Suoi requisiti di sicurezza e dal livello di automazione desiderato.
Sì — e questo sorprende la maggior parte delle persone. Tramite la stessa interfaccia vengono inseriti anche campioni, ordini, clienti e contatti, strumenti di prova, materiali e lotti, impianti, fatture e offerte, rapporti, specifiche, ricette, modelli, attività, note e registrazione delle ore lavorative. In totale si tratta di 19 tipi di dati, e ciascuno di essi può essere creato o aggiornato.
I formati più comuni sono CSV, JSON e XML. Per lo scambio di dati medici si aggiungono HL7 e LDT; inoltre, è possibile importare file PDF, PNG e JPG, come ad esempio cromatogrammi o protocolli firmati. Anche Excel è compatibile: è sufficiente salvare il file in formato CSV direttamente da Excel. Durante la creazione dell’interfaccia, si definiscono il set di caratteri, il formato della data e il separatore decimale; impostazioni errate sono la causa più frequente di caratteri diacritici distorti o valori misurati interpretati in modo errato.
Sì — non è più necessario il passaggio intermedio tramite Excel. L’uscita dello strumento, i parametri, l’identificativo del campione e il percorso di trasmissione vengono sincronizzati una sola volta; successivamente, i valori di misura vengono assegnati automaticamente al campione corretto. Ciò vale sia per strumenti quali i sistemi GC o PCR, sia per bilance e titolatori.
Sì, le macchine di prova Zwick possono essere integrate tramite un’interfaccia di importazione adeguata. A seconda della configurazione, acquisiamo il valore massimo, il valore medio, la pendenza, i dati grezzi o le curve complete — e sarete voi a stabilire quali di questi dati di misura vengano effettivamente trasferiti nel LIMS. Gli strumenti e i mezzi di prova vengono identificati in modo univoco tramite identificativi fissi, numeri di serie o codici a barre.
A tal fine è disponibile la registrazione mobile: foto, inserimento dati tramite iPad o iPhone, dettatura o inserimento manuale tradizionale. I verbali di misurazione di più pagine e le note scritte a mano vengono analizzati tramite OCR e intelligenza artificiale e convertiti in valori di misurazione strutturati. Anche le schede di campionamento possono essere acquisite in questo modo: da esse vengono generati automaticamente ordini e campioni.
Tra cui SAP, Navision, Microsoft Dynamics e AS/400. Le regole di trasformazione convertono i dati ERP in ordini, campioni e assegnazioni; come set minimo di dati sono solitamente sufficienti il numero cliente, il codice articolo e il lotto, mentre l’assegnazione univoca deriva dalla combinazione tra numero di lotto e codice articolo. Idealmente, il vostro sistema ERP rimane la fonte principale per i dati anagrafici dei clienti: il LIMS effettua regolarmente il sincronizzamento, anziché creare una seconda fonte di dati. I dati di fatturazione vengono restituiti tramite DATEV o un’interfaccia diretta con l’ERP.
Tramite l’interfaccia di importazione con assegnazione automatica dei parametri oppure, in caso di piccole quantità, tramite inserimento manuale. Il referto originale del laboratorio partner può essere allegato al campione, in modo che durante l’audit sia possibile risalire alla provenienza di un valore.
Entrambi i modelli di trasmissione sono realizzabili. La frequenza dipende dal canale di trasmissione: richiami temporizzati, ad esempio ogni dieci minuti, oppure, nel caso delle connessioni REST, una trasmissione quasi istantanea. Le importazioni possono inoltre essere avviate manualmente o in base a un valore di stato; i filtri di stato e gli identificatori univoci delle importazioni impediscono in tal modo importazioni multiple e cicli infiniti.
Sì, tramite il Model Context Protocol (MCP). In questo modo, le applicazioni di intelligenza artificiale trasmettono i dati esclusivamente attraverso le interfacce di importazione da Lei autorizzate a tale scopo — non ottengono alcun accesso aggiuntivo. L’accesso è associato a un utente LDB, si applicano i suoi diritti e ogni modifica viene registrata nell’Audit Trail con l’annotazione «MCP». In questo modo, ad esempio, un referto in patologia viene dettato anziché digitato, oppure il prelievo di un campione viene registrato a voce mentre si è in viaggio.
Sì. Potete creare una pagina HTML personalizzata o un modulo — per il prelievo dei campioni in loco, per chi invia i campioni o per una registrazione che non esiste ancora nel LIMS. Al momento dell’invio, i dati inseriti vengono trasmessi direttamente all’interfaccia di importazione tramite la ricezione HTTPS. Non viene creato alcun file che qualcuno debba caricare in un secondo momento.
Sì. Oltre al caricamento singolo, è disponibile il caricamento multiplo per intere cartelle — la procedura standard per l’importazione di dati preesistenti. In caso di recupero automatico tramite SFTP, LDB LIMS scarica fino a dieci file per ciclo, ogni dieci minuti. Quantità maggiori vengono elaborate in più cicli o tramite un contingente maggiorato.
Sì. Oltre all’importazione nel LDB LIMS, sono possibili canali di ritorno verso portali, sistemi ERP o laboratori esterni — per risultati, informazioni sullo stato o ID. Lo stato che attiva il trasferimento di ritorno e i campi che vengono ritrasmessi vengono definiti in base al singolo progetto.
Durante la mappatura, si assegnano i campi del file di importazione ai campi presenti nel LIMS: cliente, ordine, campione, punto di campionamento, parametro, valore misurato. Le assegnazioni semplici si configurano direttamente nell’interfaccia. In caso di strutture di file complesse, denominazioni divergenti o formati speciali dei valori misurati, viene aggiunto un codice di trasformazione che converte i dati prima dell’importazione. Gli amministratori del Suo laboratorio possono scrivere e gestire autonomamente tale codice; in alternativa, possiamo occuparcene noi come servizio a tariffa oraria. Una volta creato, il codice dovrebbe sempre essere verificato utilizzando file di prova rappresentativi.
Sì. L’intelligenza artificiale riconosce le colonne, suggerisce le corrispondenze e genera il codice di trasformazione: in questo modo è possibile creare una mappatura di importazione in pochi clic anziché in giorni. Tuttavia, valgono due regole: è necessario rendere anonimi in anticipo i file di esempio e verificare ogni mappatura generata automaticamente dal punto di vista sia tecnico che contenutistico.
Sono supportate entrambe le strutture. Nell’importazione orizzontale i parametri sono disposti uno accanto all’altro in colonne, mentre nell’importazione verticale sono disposti uno sotto l’altro per riga: i dati in uscita dai dispositivi sono spesso in formato verticale, mentre le esportazioni ERP sono spesso in formato orizzontale. L’unico requisito fondamentale è che la mappatura corrisponda alla struttura del file di origine; non è necessario modificare le esportazioni esistenti a tal fine.
Ciò dipende dal tipo di importazione. Per i valori di misura sono necessari almeno un campione valido, un parametro associabile e il valore di misura stesso; nel caso delle segnalazioni alle autorità, si aggiungono gli ID e i dati relativi al gestore o al punto di campionamento. I campi mancanti possono essere creati nel sistema e i modelli di importazione possono essere configurati in modo diverso a seconda della sede o del tipo di analisi.
Tramite codici articolo identici e una mappatura accurata dei dati anagrafici. Un pacchetto di analisi può raggruppare diversi parametri, tutti assegnati a un unico codice articolo. È inoltre possibile assegnare e raggruppare automaticamente più lotti provenienti da un unico file Excel, purché siano presenti caratteristiche univoche.
Ogni livello di dati necessita di una chiave univoca: numero cliente, numero d’ordine, numero di campione, ID parametro, ID paziente, identificativo del dispositivo o codice a barre. In caso di mancanza di tale chiave, sono a vostra disposizione strumenti completi: a tal fine utilizziamo tutti i campi dei dati anagrafici disponibili oppure combiniamo più campi per ottenere una chiave di corrispondenza.
Sì. I codici a barre identificano campioni, materiali, lotti, strumenti di prova e apparecchiature; i materiali e i lotti possono essere scansionati direttamente. È necessario che il codice sia memorizzato in modo coerente sia nel sistema di origine che nel database del laboratorio e che venga preso in considerazione nella mappatura. In alternativa, il numero di serie funge da identificativo univoco di un’apparecchiatura.
Tramite ID univoci, regole di corrispondenza coordinate e la modalità di importazione adeguata. La modalità standard update sovrascrive un valore esistente anziché creare un secondo record: se lo stesso file venisse importato nuovamente per errore, non si verificherebbe alcun duplicato. La definizione dei campi chiave è particolarmente critica nel caso di clienti, pazienti, sedi e campioni. Inoltre, i controlli sui campi obbligatori e di convalida impediscono che dati incompleti o contraddittori vengano elaborati.
Entrambe le opzioni sono configurabili, con precisione a livello di campo: è possibile specificare quali campi possono essere sovrascritti durante un'importazione e quali devono rimanere invariati. Si raccomanda di verificare espressamente i valori vuoti, i contenuti già presenti e i casi particolari specifici del settore, affinché nulla venga sovrascritto involontariamente.
Sì. Ad ogni processo di importazione viene assegnato un ID univoco, con il quale tutti i dati correlati vengono memorizzati e rimangono accessibili in qualsiasi momento — compresi i dati grezzi. In questo modo è possibile tracciare quando è stato importato un determinato file, tramite quale interfaccia, quali record di dati ne sono derivati e chi ha avviato l’importazione. Ogni processo può inoltre essere ripetuto.
Ogni interfaccia viene innanzitutto configurata nel sistema di test e verificata utilizzando file di esempio rappresentativi e, per quanto possibile, resi anonimi. Vengono testati non solo i casi standard, ma espressamente anche i campi obbligatori mancanti, gli ID sconosciuti, i caratteri speciali, i valori vuoti e i casi particolari specifici del settore. Solo dopo una validazione riuscita l’interfaccia viene trasferita nel sistema operativo, con dati di accesso e collegamenti distinti per entrambi gli ambienti.
Verifichi innanzitutto il file di origine, le chiavi utilizzate, la mappatura e la logica di trasformazione; i registri degli errori indicano in quale punto si verifica il problema. Per il servizio di assistenza sono particolarmente utili il file di importazione reso anonimo, l’interfaccia interessata, l’ID campione o di importazione, il messaggio di errore specifico e una breve descrizione del risultato che si sarebbe aspettato. In questo modo è possibile individuare la causa in modo molto più rapido.
La creazione e la modifica delle interfacce di importazione sono riservate ai ruoli amministrativi. Per gli accessi SFTP e API sono previsti dati di accesso sicuri, nonché accessi separati per l’ambiente di test e quello produttivo; inoltre, le responsabilità tra il laboratorio, il reparto IT e il servizio di gestione delle interfacce sono espressamente definite. I dati sensibili relativi alle misurazioni e ai pazienti transitano esclusivamente attraverso canali concordati e protetti; per i file di esempio e il mapping supportato dall’intelligenza artificiale, l’anonimizzazione è obbligatoria.
Sì. Nell’ambito dell’implementazione utilizziamo proprio queste interfacce di importazione per migrare i Suoi dati preesistenti: non è necessario alcun strumento di migrazione separato. In questo modo, i risultati storici delle verifiche, i dati anagrafici dei clienti e dei parametri, nonché grandi quantità di vecchi certificati di taratura, ad esempio provenienti da Lotus Notes, vengono trasferiti nel LDB LIMS e sono quindi normalmente disponibili per le analisi. I file CSV strutturati sono i più adatti; quanto più pulita è la struttura dei dati preesistenti, tanto minore sarà il lavoro di rielaborazione necessario. Il vantaggio: l’interfaccia utilizzata per la migrazione è la stessa che verrà poi impiegata nelle operazioni quotidiane.
Per un’interfaccia dati di misurazione, la procedura concreta è la seguente:
  1. Aprire il file di esportazione del dispositivo in Excel e salvarlo come CSV con set di caratteri UTF-8.
  2. Verificare la riga degli attributi e inserire il nome del parametro tratto dal file di esportazione nel campo dei dati anagrafici dei parametri Chiave di importazione.
  3. In Campioni → Interfacce di importazione CSV → Nuova interfaccia creare l’interfaccia: selezionare il tipo Dati di misura, impostare il set di caratteri UTF-8 e spuntare la casella Importazione campioni.
  4. Se la riga degli attributi manca o è incompleta: integrare le intestazioni delle colonne — devono essere univoche e non contenere spazi — e specificare a partire da quale riga deve iniziare l’importazione.
  5. Caricare il file, effettuare il mapping e assegnare i dati.
  6. Accedere al campione e caricare il file in quella sede.
Successivamente, verificare la presenza di errori e casi particolari nel sistema di test, avviare la produzione con una piccola quantità di dati e potenziare l’automazione e il monitoraggio. I campi obbligatori, la logica di stato, il formato dei dispositivi e le regole di corrispondenza vengono definiti insieme durante il workshop sull’interfaccia.

Passo dopo passo, con video incluso: Importare i dati di misurazione. Approfondimenti: Panoramica delle interfacce di importazione, Creare un’interfaccia di importazione dei dati di misura in formato CSV, Importazione dei risultati dagli strumenti di misura, Codice di trasformazione per altri formati di dati, Importazione automatica tramite FTP/SFTP e Estensione basata sull’intelligenza artificiale delle interfacce di importazione.

Sì. Ogni interfaccia di importazione dispone di un proprio endpoint HTTPS, al quale un sistema esterno invia i propri dati tramite POST — autenticandosi tramite Basic Auth o certificato. L’endpoint risponde con il codice 200 se i dati sono stati acquisiti e con il codice 400 se sono stati ricevuti ma non è stato possibile elaborarli; ogni tentativo viene visualizzato nella panoramica delle interfacce. Nella direzione opposta, le analisi mettono a disposizione i dati che un sistema esterno o un assistente IA è autorizzato a recuperare. Il manuale descrive la struttura e la procedura di test.
Sì. I vostri amministratori possono creare autonomamente una nuova interfaccia CSV: caricare un file di esempio, selezionare il separatore e il set di caratteri, assegnare le colonne ai campi di destinazione e salvare. Le competenze di programmazione sono necessarie solo nel caso in cui sia richiesto un codice di trasformazione per un formato non comune — e anche in tal caso i vostri amministratori possono scriverlo e gestirlo autonomamente.
Sì. Il set di caratteri, il formato della data e il separatore decimale vanno impostati per ciascuna interfaccia. In questo modo, un dispositivo che utilizza il punto come separatore decimale o che fornisce le date nel formato MM/GG/AAAA verrà letto correttamente. L'esperienza dimostra che valori impostati in modo errato in questa sezione sono la causa più frequente di caratteri dieresi distorti e valori di misura interpretati in modo errato.
Sì, si tratta addirittura della situazione normale. Molti laboratori iniziano con i dati anagrafici — clienti, parametri, valori limite — e lasciano inizialmente la cronologia dei risultati nel sistema precedente. I dati che vengono generati in quel sistema durante il funzionamento in parallelo verranno recuperati in un secondo momento tramite la stessa interfaccia di importazione; un secondo ciclo di migrazione non rappresenta un caso eccezionale. Sarete voi a decidere quale parte della cronologia trasferire.
Sì, e la correzione rimane tracciabile. L’audit trail registra chi ha modificato quale valore e quando; il valore importato originariamente non va perso. Tramite i diritti di accesso è possibile stabilire chi è autorizzato ad apportare correzioni e chi ha solo diritti di lettura.
Non si tratta di un monitoraggio delle cartelle nel senso classico del termine — a tal fine si utilizza SFTP. Il Suo dispositivo o il Suo server salva i file in una directory SFTP; LDB LIMS li recupera automaticamente ogni dieci minuti, fino a un massimo di dieci file per ciclo, per poi spostarli o eliminarli. Per i Suoi collaboratori il risultato è lo stesso: è sufficiente archiviare il file, nessuno deve caricare nulla.
Sì. La connessione non è unidirezionale: LDB LIMS può inviare richieste tramite API REST al dispositivo o a un sistema esterno — ad esempio, invia un numero di campione e il dispositivo risponde con i risultati relativi proprio a quel campione. Questo è il metodo più elegante se non si desidera che il dispositivo salvi alcun file o se si desidera controllare quando vengono recuperati determinati dati. I dati che LDB LIMS, a sua volta, fornisce possono essere definiti tramite Analisi.
Sì, entrambi. AnIML lo implementiamo insieme al nostro partner Splashlake, mentre LDB LIMS è compatibile con SiLA. Soprattutto nei bandi di gara questi due standard vengono spesso richiesti; nella pratica, tuttavia, la maggior parte delle integrazioni continua a avvenire tramite CSV, file di esportazione specifici per dispositivo e l’API REST.

Onboarding: interfacce di importazione

Importare automaticamente i valori di misura, i campioni e i dati dei clienti da dispositivi, laboratori esterni e sistemi ERP

  1. Importare i valori misurati dai file CSV
  2. Diritti di accesso, chiave di importazione e modalità di importazione
  3. Mappatura delle importazioni tramite IA senza conoscenze di programmazione
  4. Integrazione dei file GC e HL7 tramite codice di trasformazione
  5. Automazione tramite HTTPS e SFTP, integrazione con i sistemi ERP
  6. Domande frequenti sull'argomentoInterfacce di importazione e LIMS

Funzionalità LDB

Sistema di gestione delle informazioni di laboratorio (LIMS)