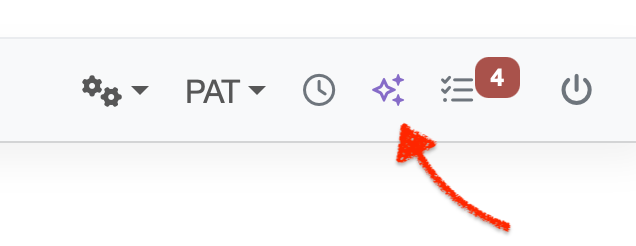
AI Explorer 直接集成于 LDB,在每个页面右上方的菜单栏中显示。例如,在样品视图中,您可以通过聊天向人工智能查询该样品的信息,如:“汇总此样品的结果,并检查测量结果的合理性。”人工智能了解该样品的上下文,包括基础数据、参数、测量值、目标值、委托等,并据此在几秒内直接在相关样品页面给出答案。
LDB 的其他页面也采用相同方式。例如,在客户页面可以询问:“该客户去年完成了哪些委托?”在检测设备页面可以询问: “下一次校准是什么时候?”通过这种结合上下文的方法,LDB 成为您的个人智能助手,替您完成重复的信息查找,并以易于理解的方式回答复杂问题。
人工智能回答的质量,很大程度上取决于提问时提供了哪些上下文背景信息。 我们非常重视上下文工程,也就是始终自动为人工智能提供与相应数据类型有关的适当数据和补充信息。 上下文工程的原则,是让人工智能系统在执行任务时获得“格式正确、内容适当的信息”。 只有获得正确的上下文,人工智能才能给出可靠的答案。
因此,我们在 LDB 中为每种数据类型设计了专属的上下文信息包。例如,查询样品时,人工智能会获得参数和测量值、限值信息、样品备注及关联委托数据。查询客户时,则会同时提供委托历史、联系人及待处理事项等背景信息。您输入问题时,系统会在后台全自动动态整理这些上下文。 由此,人工智能能够“理解”问题所指,给出高质量、精确的回答,而非泛泛而谈。 这种精心准备上下文的方式,使我们的人工智能集成明显区别于简单的演示。普通聊天机器人与 AI Explorer 的主要区别,就在于所提供上下文的质量。
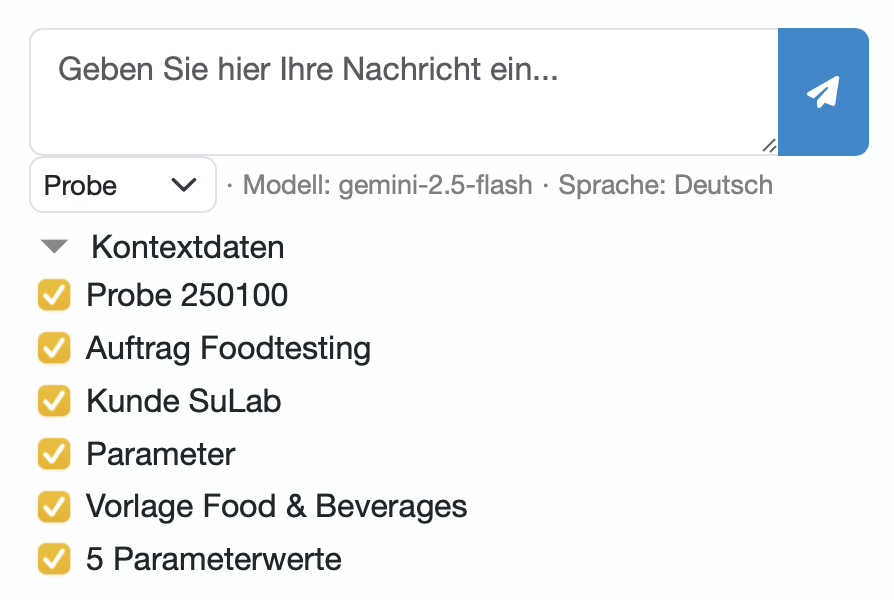
透明性是 AI Explorer 的核心要素。我们希望您能够充分信任 LDB 的人工智能集成。因此,在将上下文数据发送给人工智能模型之前,我们会逐项列出数据,并通过复选框让您确认授权。
系统会考虑提问用户的访问权限,仅建议使用该用户具有读取权限的数据。这样,在使用人工智能时,LDB 的访问权限仍然有效,您也能始终全面掌控自己的数据。
在 LDB 中,每次人工智能对话都会结合上下文,保存在相应记录及用户下。 例如,您对某个样品提出一组连续问题,先问“此样品有哪些测量值超出目标值?”,再问“可能是什么原因造成的?”AI Explorer 会将对话直接保存在该样品中。即使数周后,您仍可打开该样品,查看已保存的聊天记录,包括所有问题、上下文信息及人工智能回答。您可以继续提问,也可以围绕该样品开启新对话。
按记录持久保存聊天历史有显著优势。一方面,它可作为文档记录,让您或同事随时追溯人工智能曾对某项业务给出哪些信息。另一方面,它有助于团队协作:如果实验室负责人已对某项委托进行人工智能分析,同事稍后可查看并继续该对话,无需重新组织问题。知识与见解不会丢失,而是保存在应有的位置——系统中对应的数据记录里,供随时查阅。
我们特别为初次使用人工智能的用户准备了贴近日常实践的示例问题。每个页面都有与相应数据类型匹配的预设问题。只需点击其中一个问题,AI Explorer 就会结合该记录的上下文数据作答。
例如,在物料页面,示例问题可以是: “这种物料的哪些批次即将到期?”这有助于您了解人工智能如何从数据中提取相关信息并作答。对于客户记录,示例问题可以是:“列出该客户最近完成的委托。”这些一键提问降低了使用门槛,让您快速了解可以向人工智能询问哪些内容。
我们精心选择示例问题,并不断扩充,以提供实际价值、覆盖常见应用场景。这样,每位用户都能轻松使用人工智能,并立即获得有助于工作的结果。